AIソリューション / 音声ノイズ除去

アイリア Voice Filter
雑音の中でも、あなたの声を、
鮮明に届ける。

インターホンの応対、駅や街中からの通話、ブラウザでの WEB 会議、ゲームのボイスチャット。 周囲の雑音と、隣で話す他の人の声を取り除き、届けたい声だけを相手に伝えるリアルタイム音声ノイズ除去を、 OSS モデルと当社独自モデルの 2 種類で提供します。 推論は端末内で完結し、音声を外部へ送信する必要がありません。

  • 遅延 30〜40 ms のリアルタイム処理
  • 話者を選べる独自モデル
  • ブラウザでも組み込みでも動く
  • 端末内で完結、音声を外に出さない

導入検討の前に、
ブラウザでそのまま試せます

同じモデルを ailia.js でブラウザ内実行するデモを公開しています。 マイクにつないで話すか、手持ちの音声ファイルを読み込むだけで、処理前と処理後を聴き比べられます。 アイリア Voice Filter と DeepFilterNet3 の両方を同じ画面で切り替えられるので、 自社の想定環境にどちらが合うかをその場で確かめられます。

音声はどこにも送信されません。 推論はすべてブラウザ内(WebAssembly)で完結します。 雑音を足して試す機能、処理前・処理後の再生と WAV 保存、 自分の声を登録して他の人の声を消す「話者抽出」も試せます。

ライブデモを開く
DEMO
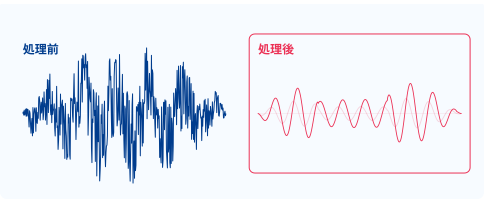
処理前と処理後の波形

処理前(左)と処理後(右)の波形を並べて表示します

  • 実行環境ブラウザ(WebAssembly)
  • 入力マイク / 音声ファイル
  • モデルアイリア Voice Filter / DeepFilterNet3 を切替
  • 音声の送信なし(端末内で完結)

「声が聞き取れない」が起きる、4 つの現場

マイクが屋外や騒がしい場所にある機器・アプリケーションで、聞き取りやすさは体験の質そのものです。

01

インターホン・住宅設備

屋外の雑音を消して、来訪者の声をはっきり室内へ

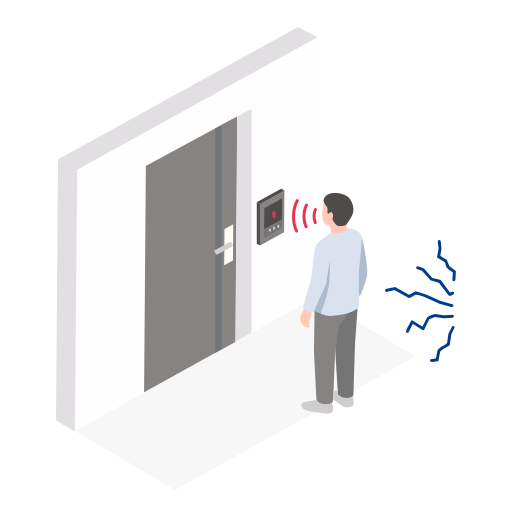
玄関子機のマイクは屋外にあり、風の音、車の走行音、雨音、近隣の工事音がそのまま入ります。 聞き返しが増えれば応対の体験は下がり、宅配や介護の現場では聞き間違いが業務ミスにつながります。 子機または親機の中で雑音を取り除き、来訪者の声だけを室内に届けることで、 マイクや設置場所を変えずに聞き取りやすさを改善できます。

  • 集合住宅・戸建て向けインターホンの通話品質向上
  • ナースコール、施設の受付端末、ドアホン連携カメラ
  • 音声認識や録音の前処理としての雑音除去

この現場で効く理由 インターホンの子機・親機に載る CPU は限られています。約 2.3M パラメータ・48 kHz・遅延 40 ms のモデルは、 組み込み向けのプロセッサでもリアルタイムに動作します。クラウドを経由しないため、 通信環境に左右されず、住戸内の会話が外部へ出ることもありません。
02

通話(電話・スマートフォン・
コールセンター)

駅のホームや街中からの通話でも、相手に届くのは静かな部屋の声

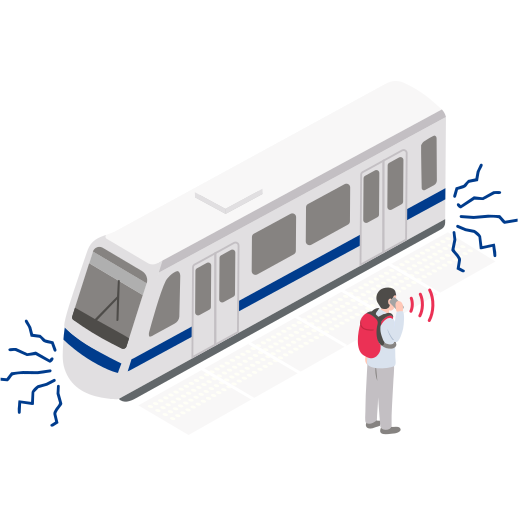
電車の走行音、アナウンス、雑踏、店内の BGM。移動中の通話は、話し手には気にならない雑音が 相手には大きく聞こえます。端末側で送話音声から雑音を取り除くことで、回線やアプリを問わず、 相手には静かな部屋から話しているように届きます。 隣で話している人の声が入ってしまう場面では、話者抽出で自分の声だけを残せます。

  • 通話アプリ、業務用トランシーバー、コールセンターのヘッドセット
  • 音声認識・議事録作成の前処理(認識率の改善)
  • 登録した話者の声だけを残す話者抽出(アイリア Voice Filter)

この現場で効く理由 通話で許される遅延は限られています。1 フレーム 10 ms 単位のストリーミング処理で、 アルゴリズム遅延は アイリア Voice Filter で 40 ms、DeepFilterNet3 で 30 ms。 アイリア SDK は iOS / Android / Windows / Linux で同じモデルを動かせるため、 端末ごとの作り分けが要りません。

03

WEB 通話・オンライン会議

ブラウザの中だけで完結する、プラグイン不要のノイズ除去

在宅やカフェからの WEB 会議では、キーボードの打鍵音、空調、家族の声、店内の話し声がそのまま入ります。 ailia.js を使えば、同じモデルが WebAssembly としてブラウザの中で動くため、 利用者にアプリやプラグインを入れてもらう必要がなく、サーバー側で音声を処理するコストもかかりません。 WebRTC の音声経路に組み込めば、既存の WEB 会議・WEB 接客サービスにそのまま追加できます。

  • WEB 会議、WEB 接客、オンライン診療、遠隔サポート
  • ブラウザ完結のため配布・インストールが不要
  • 音声をサーバーへ送らないため、プライバシーとコストの両面で有利

この現場で効く理由 このページのライブデモは、まさにその構成で動いています。ブラウザ内の推論は シングルスレッドの WebAssembly で実時間より十分速く、CPU を占有しません。 ネイティブアプリと同じモデル・同じ API なので、ブラウザで検証した品質をそのまま製品へ展開できます。

04

ゲーム・ボイスチャット

ゲーム音や部屋の雑音を消して、味方に声を届ける

ボイスチャットには、スピーカーから漏れるゲーム音、コントローラーやキーボードの操作音、 同じ部屋にいる家族の声が入ります。相手に届く声が聞き取りにくいと、連携も配信の視聴体験も損なわれます。 ゲーム機や PC の中で送話音声から雑音を取り除き、話者抽出で自分の声だけを残すことで、 どんな環境からでも同じ品質の声を届けられます。

  • ゲーム内ボイスチャット、配信・実況の送話音声
  • VR / メタバースの音声コミュニケーション
  • ゲーム内の音声コマンド認識の前処理

この現場で効く理由 ゲームでは GPU も CPU も描画とゲームロジックに使われています。約 2M パラメータのモデルは CPU の 1 コアの一部で動作し、ゲームのフレームレートに影響しません。 遅延は 30〜40 ms で、会話のテンポを崩しません。

雑音を消すだけでなく、「誰の声を残すか」まで選べます

一般的なノイズ除去は、人の声以外を消します。隣の人の声も「人の声」なので残ってしまいます。 当社独自の アイリア Voice Filter は、登録した話者の声だけを残す話者抽出まで一つのモデルで行います。 話者を登録しなければ全員の声を残す通常のノイズ除去として動き、その条件でも OSS モデル DeepFilterNet3 とほぼ同等です。比較用に DeepFilterNet3 も合わせて提供します。

雑音を消して、声だけを残す

走行音、空調、雑踏、打鍵音といった環境雑音を深層学習モデルで取り除きます。 スペクトルを帯域ごとに抑える従来型のマスク推定に加え、 Deep Filtering(複素スペクトルの複数フレームにわたるフィルタ)で 声の倍音構造を崩さずに雑音を取り除くため、処理後の声が不自然になりにくいのが特徴です。

届けたい人の声だけを残す(話者抽出)

アイリア Voice Filter は、数秒の音声から取り出した話者の特徴ベクトル(d-vector)を条件として、 登録した人の声だけを残し、他の人の声も雑音として取り除きます。 2 話者+雑音の評価では、話者を選べない一般的なノイズ除去が入力より悪化する条件で、 唯一、入力を改善しました(SI-SDR −3.74 → +0.99 dB)。 登録しなければ、全員の声を残す通常のノイズ除去として動作します。

低遅延のストリーミング処理

10 ms のフレーム単位で逐次処理し、未来の音を待ちません。 アルゴリズム遅延は アイリア Voice Filter で 40 ms、DeepFilterNet3 で 30 ms。 ストリーミング処理の出力は一括処理と一致することを検証済みで、 通話やボイスチャットのようにリアルタイム性が求められる用途にそのまま使えます。

端末内で完結。音声を外に出さない

推論は端末内で完結し、音声をクラウドへ送る必要がありません。 通話やインターホンの会話は機微な情報を含みますが、原音声が端末の外に出ない構成を取れるため、 プライバシーの説明がしやすく、通信費やサーバー費も発生しません。 通信が不安定な環境でも品質が変わりません。

ブラウザでも、組み込みでも、同じモデル

アイリア SDK は Windows / Linux / macOS / iOS / Android / 組み込み Linux、 そしてブラウザ(ailia.js、WebAssembly)まで同一の API で動作します。 このページのライブデモはブラウザ上で動いており、 PC で検証した構成をそのままスマートフォンアプリや機器に展開できます。 CPU だけで実時間処理でき、GPU や NPU があればさらに軽くなります。

1 人でも複数人でも使える、独自モデル

1 人の声+雑音でも、アイリア Voice Filter は話者を登録せずに使えば OSS モデル DeepFilterNet3 とほぼ同等です(PESQ 3.050 対 3.237、SI-SDR 19.19 対 19.67 dB)。 複数の人の声+雑音になると、話者を選べる アイリア Voice Filter だけが有効です。 比較用に DeepFilterNet3 も同じ仕組みで提供しており、後から切り替えることも併用することもできます。

2 つのモデルと、条件別の実測値

公開データセットを使い、同じ音声・同じ指標で比較しました。 SI-SDR(SI-SNR)は雑音や歪みに対する目的音声の比率(dB、大きいほど良い)、 PESQ は音質(1〜4.5、大きいほど良い)、STOI は明瞭度(0〜1、大きいほど良い)の指標です。

当社独自

アイリア Voice Filter

1 話者・複数話者とも推奨

DeepFilterNet3 の重みを起点に、話者ベクトルによる条件付けを加えて 48 kHz で学習した当社独自モデル。 登録した話者の声だけを残す話者抽出と、登録なしの通常のノイズ除去の両方を 1 つのモデルで行います。

標本化周波数
48 kHz
遅延
40 ms
パラメータ数
2.27M
話者選択
あり(d-vector 256 次元)
提供形態
アイリア SDK 専用モデル

OSS

DeepFilterNet3

話者選択が不要な場合の比較対象

広く使われている OSS の低遅延ノイズ除去モデル。48 kHz の広帯域音声に対応し、 1 人の声+雑音の条件では高い雑音抑圧と音質を示します。話者を選ぶことはできません。 アイリア SDK / ailia.js で動くよう、ストリーミング処理用のグラフとして書き出して提供します。

標本化周波数
48 kHz
遅延
30 ms
パラメータ数
2.14M
話者選択
なし
ライセンス
MIT / Apache-2.0(DeepFilterNet プロジェクト)
公開データセットでの比較(当社測定、48 kHz で評価)。SI-SDR の単位は dB。いずれも大きいほど良い
モデル 条件 SI-SDR PESQ STOI 話者選択
アイリア Voice Filter(当社独自) 1 話者+雑音(話者登録なし) 19.19 3.050 0.942 あり
1 話者+雑音(話者登録あり) 17.55 2.917 0.939
2 話者+雑音(話者登録あり) +0.99 1.284 0.674
DeepFilterNet3(OSS) 1 話者+雑音 19.67 3.237 0.944 なし
2 話者+雑音 −5.13 1.163 0.544
RNNoise(OSS) 1 話者+雑音 11.07 2.292 0.902 なし
2 話者+雑音 −4.93 1.124 0.536
入力(未処理) 1 話者+雑音 8.47 2.173 0.919 —
2 話者+雑音 −3.74 1.088 0.622

1 話者ノイズ(話し手が 1 人+環境雑音)

アイリア Voice Filter を話者登録なしで使用

話者を登録せず全員の声を残すモードでは、SI-SDR 19.19 dB、PESQ 3.050。 DeepFilterNet3(19.67 dB、3.237)との差は SI-SDR で 0.48 dB、PESQ で 0.187 です。 話し手が 1 人しかいない音声で話者を指定することは情報を足さないため、 環境雑音だけを消したい場合は話者登録なしで使う方が良い結果になります。

複数話者ノイズ(周囲に他の話し手がいる)

アイリア Voice Filter を話者登録ありで使用

2 話者+雑音では、話者を選べないモデルは他の人の声を残したまま目的の声を傷つけ、入力より悪化します(SI-SDR −3.74 → −5.13 dB)。 話者を登録した アイリア Voice Filter だけが入力を改善しました(+0.99 dB、差は 6.12 dB)。 登録する話者を別人に入れ替えると −13.89 dB になり、指定した話者が実際に選ばれていることを示しています。

1 話者+雑音は VoiceBank-DEMAND テストセットの 200 発話、2 話者+雑音は LibriSpeech dev-clean の 2 話者混合 200 件に DEMAND の雑音を加えたもので測定しました。 実環境での性能はマイク、雑音の種類、話者の距離に左右されます。想定環境の録音をお預かりしての個別評価も承ります。

技術仕様

処理パイプライン

  1. フレーム分割・STFT10 ms ホップの逐次処理。未来のサンプルは最小限
  2. ERB 帯域の特徴抽出聴覚特性に沿った 32 帯域で雑音の状態を推定
  3. 話者ベクトルによる条件付けアイリア Voice Filter のみ。登録した声の d-vector を加算
  4. Deep Filtering複素スペクトルを複数フレームにわたって整形
  5. 逆 STFT・重畳加算1 ホップ分の波形を出力

モデル

アイリア Voice Filter
48 kHz、2.27M パラメータ、遅延 40 ms。話者選択あり
DeepFilterNet3
48 kHz、2.14M パラメータ、遅延 30 ms。話者選択なし
話者登録
その人だけが話している数秒の音声から d-vector(256 次元)を算出
入力
モノラル音声(マイク / ファイル / 音声ストリーム)
形式
アイリアSDK専用ONNX

動作環境

OS
Windows / Linux / macOS / iOS / Android / 組み込み Linux
ブラウザ
ailia.js(WebAssembly)
演算
CPU 単体で実時間処理。GPU / NPU による高速化にも対応
言語
C++ / C# / Python / JavaScript / Java / Rust など

対応環境の詳細は アイリア SDK のページをご覧ください。

まずは、自分の声と環境で試してください

ブラウザデモは登録不要でその場で動きます。 想定環境の録音を使った精度評価、既存の通話アプリ・機器への組み込み、 組み込みプロセッサでの動作確認についても個別にご相談を承ります。